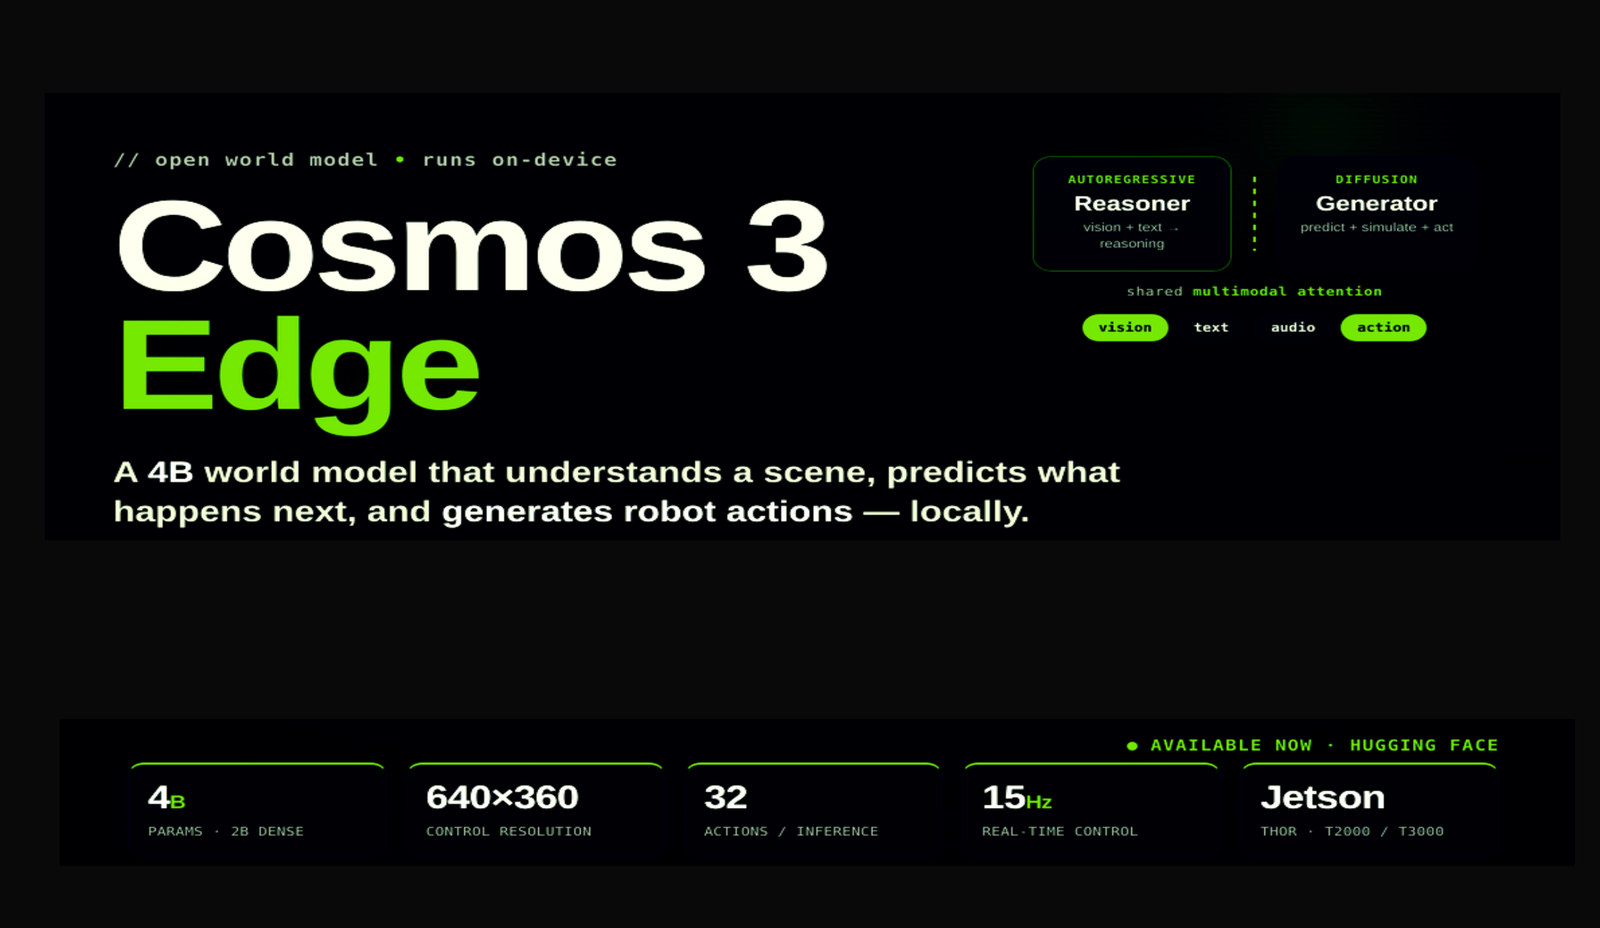
Rettifica del 17 ottobre 2026. Conservato annuncio 4B; corretti data, base model vs policy e azioni vs inferenze. Omessi dettagli non confermati.
NVIDIA ha reso disponibile Cosmos 3 Edge, un modello da quattro miliardi di parametri destinato allo sviluppo di sistemi di AI fisica con elaborazione locale. Il resoconto ufficiale SIGGRAPH del 20 luglio 2026 ne descrive il rilascio e l’impiego su piattaforme Jetson, RTX e DGX. L’annuncio è confermato, ma un modello di base non equivale a un robot pronto a svolgere qualsiasi compito.
Il posto di Edge nella famiglia Cosmos
Cosmos 3 comprende più dimensioni, pensate per esigenze differenti. L’annuncio della famiglia distingueva Super e Nano da Edge, inizialmente indicato come successivo arrivo. Il rilascio documentato a SIGGRAPH completa quindi una cronologia che va descritta senza sovrapporre presentazione della famiglia e disponibilità di ciascun modello.
NVIDIA presenta Edge come un modello compatto per comprensione e generazione multimodale legate al mondo fisico. Questa impostazione può sostenere sviluppo di analisi video e sistemi robotici, ma le capacità del modello vanno separate dall’applicazione che lo collega a sensori, attuatori e procedure operative.
Dal modello alla policy robotica
La guida tecnica sul controllo locale spiega un percorso di post-training con dati del robot, configurazione dello spazio delle azioni e valutazione. Le informazioni sullo stato del braccio e della pinza sono parte dell’input. Cambiare robot richiede quindi un adattamento concreto, non soltanto scaricare gli stessi pesi.
Nel caso documentato, la policy produce sequenze di azioni future eseguite attraverso un ciclo di osservazione e ripianificazione. La frequenza delle azioni non coincide automaticamente con la frequenza di inferenza del modello. Presentare una sequenza come un insieme di movimenti simultanei rende poco comprensibile il funzionamento del sistema e sovrastima ciò che il benchmark misura.
Che cosa valutare prima di un progetto industriale
Per un’impresa manifatturiera, l’elaborazione locale può essere interessante quando connettività, tempi di risposta o gestione dei dati rendono difficile affidare ogni passaggio a un servizio remoto. Il valore effettivo dipende però dal compito, dall’hardware e dal sistema completo. Un componente locale non garantisce da solo che tutti i dati rimangano all’interno della macchina.
Una sperimentazione dovrebbe partire da un processo delimitato e da criteri di successo misurabili. Occorre raccogliere dati rappresentativi, verificare gli errori e confrontare la soluzione con le alternative già disponibili. La simulazione e la valutazione della policy aiutano a capire se il comportamento osservato regge anche fuori dalla dimostrazione.
Nota di correzione: modello, dimensione e disponibilità sono confermati. Sono stati corretti il riferimento cronologico e la descrizione delle azioni, eliminando la promessa di controllo universale. Coalizione giapponese, sigle hardware e citazioni non rintracciate nelle fonti consultate sono stati omessi, senza considerarli per questo automaticamente falsi.
Fonti e verifica
Fonti consultate nella revisione del 17 ottobre 2026. Gli annunci dei produttori sono attribuiti come tali, non presentati come prove indipendenti.